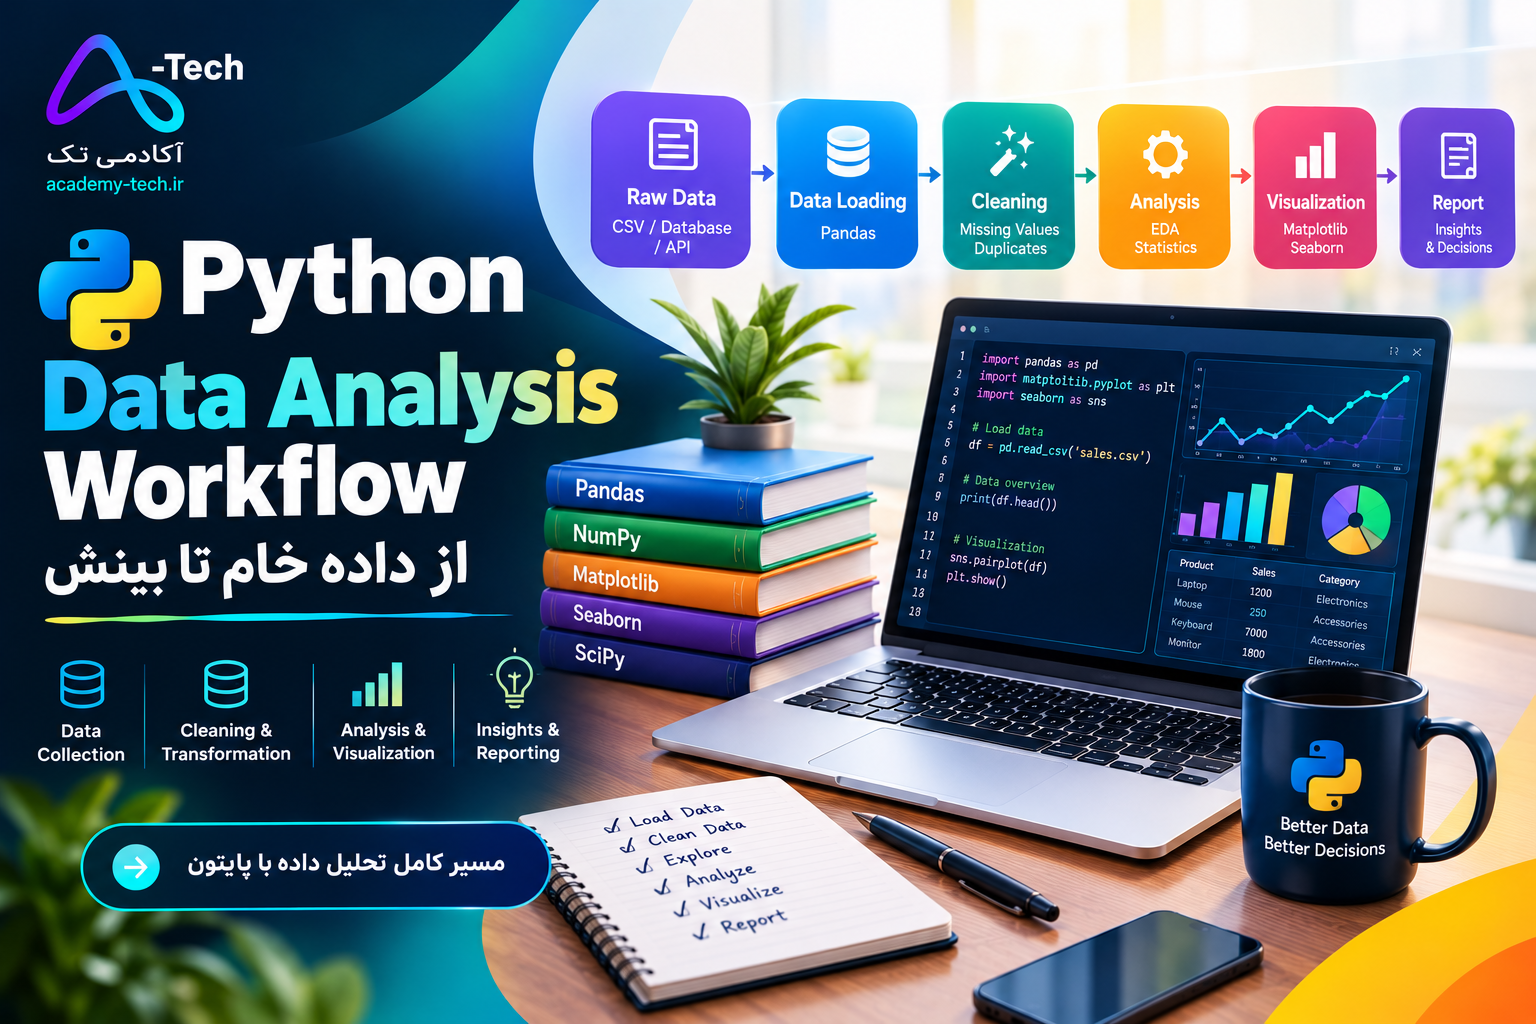
Python Data Analysis Workflow: از داده خام تا بینش
Workflow تحلیل داده با Python چیست؟
Python Data Analysis Workflow مجموعهای از مراحل منظم و قابل تکرار است که تحلیلگر داده برای تبدیل Raw Data به Meaningful Insights طی میکند.
در یک پروژه واقعی، تحلیل داده معمولاً با یک سؤال یا مسئله شروع میشود، نه با اجرای مستقیم کد Python.
یک Workflow استاندارد میتواند به شکل زیر باشد:
Business / Research Question
          ↓
Data Collection
          ↓
Data Loading
          ↓
Data Inspection
          ↓
Data Cleaning
          ↓
Data Transformation
          ↓
Exploratory Data Analysis (EDA)
          ↓
Statistical Analysis
          ↓
Data Visualization
          ↓
Insight Generation
          ↓
Communication / Reporting
          ↓
Action / Decision
Python میتواند در بسیاری از این مراحل نقش داشته باشد و کتابخانههایی مانند Pandas، NumPy، Matplotlib، Seaborn و SciPy ابزارهای رایجی برای این فرآیند هستند.
اما یک نکته اساسی وجود دارد:
Data Analysis فقط نوشتن Python Code نیست.
یک تحلیل حرفهای باید از یک سؤال مشخص شروع شود، کیفیت داده را بررسی کند، روش تحلیل مناسبی انتخاب کند و در نهایت نتایج را به شکل قابل فهم و قابل استفاده ارائه دهد.
چرا داشتن یک Data Analysis Workflow مهم است؟
اگر تحلیل داده بدون Workflow مشخص انجام شود، ممکن است مشکلاتی مانند موارد زیر ایجاد شوند:
- تحلیل بر اساس سؤال اشتباه
- استفاده از داده نامعتبر
- نادیده گرفتن Missing Values
- حذف اشتباه Outliers
- انتخاب نمودار نامناسب
- تفسیر نادرست Correlation
- ایجاد نتایج غیرقابل تکرار
- دشواری در بررسی و اصلاح کد
- نتیجهگیری بدون ارتباط با سؤال اصلی
یک Workflow منظم باعث میشود مراحل تحلیل قابل پیگیری، قابل بررسی و تا حد امکان قابل تکرار باشند.
مراحل اصلی Python Data Analysis Workflow
در ادامه، یک Workflow کامل را مرحلهبهمرحله بررسی میکنیم.
مرحله 1: تعریف مسئله و سؤال تحلیلی
اولین مرحله Data Analysis، Python نیست.
اول باید مشخص شود:
What problem are we trying to solve?
فرض کنید یک فروشگاه آنلاین با کاهش فروش مواجه شده است.
سؤال مبهم:
چرا فروش کم شده است؟
میتواند به سؤالهای دقیقتری تبدیل شود:
- فروش در کدام ماه کاهش یافته است؟
- کدام Product Category بیشترین افت را داشته است؟
- آیا تعداد سفارشها کاهش یافته یا Average Order Value؟
- آیا کاهش فروش در همه Customer Segments رخ داده است؟
- آیا تغییر در Marketing Campaignها با کاهش فروش ارتباط دارد؟
این مرحله Problem Definition نام دارد.
مرحله 2: تعیین Data Requirements
پس از مشخص شدن سؤال، باید مشخص کنیم چه دادهای نیاز داریم.
برای مثال، اگر هدف بررسی فروش باشد، ممکن است به متغیرهایی مانند:
Order ID
Customer ID
Order Date
Product
Category
Quantity
Price
Discount
Revenue
Marketing Channel
Customer Segment
نیاز داشته باشیم.
این مرحله مشخص میکند:
What data do we need?
مرحله 3: جمعآوری داده — Data Collection
داده ممکن است از منابع مختلفی دریافت شود.
برای مثال:
- CSV Files
- Excel Files
- SQL Databases
- APIs
- Web Applications
- Sensors
- Surveys
- Experimental Systems
- Cloud Storage
برای مثال، یک Dataset ممکن است در فایل CSV قرار داشته باشد:
sales.csv
یا در یک Database ذخیره شده باشد.
مرحله 4: وارد کردن داده به Python
پس از آماده شدن داده، آن را وارد محیط Python میکنیم.
برای Datasetهای جدولی، Pandas یکی از ابزارهای رایج است.
import pandas as pd

df = pd.read_csv("sales.csv")
اکنون داده در یک DataFrame قرار گرفته است.
DataFrame چیست؟
DataFrame یک ساختار داده جدولی در Pandas است که میتوان آن را بهصورت ساده مشابه یک جدول در نظر گرفت.
مثلاً:
| Date | Product | Quantity | Revenue |
|---|---|---|---|
| 2026-01-05 | Laptop | 2 | 2400 |
| 2026-01-08 | Mouse | 5 | 250 |
| 2026-01-12 | Keyboard | 3 | 210 |
در Python:
print(df.head())
اولین ردیفهای Dataset نمایش داده میشوند.
مرحله 5: Data Inspection
قبل از هر نوع تحلیل، باید Dataset را بررسی کنیم.
سؤالات مهم:
- چند ردیف داریم؟
- چند ستون داریم؟
- نوع داده هر ستون چیست؟
- آیا Missing Values وجود دارد؟
- آیا Duplicate Records وجود دارد؟
- محدوده مقادیر چگونه است؟
- آیا دادهها منطقی هستند؟
بررسی ابعاد Dataset
df.shape
مثلاً:
(10000, 8)
یعنی Dataset شامل 10,000 ردیف و 8 ستون است.
بررسی نام ستونها
df.columns
بررسی نوع دادهها
df.dtypes
برای مثال ممکن است خروجی نشان دهد:
Age          int64
Revenue    float64
Category     object
Date         object
در این مرحله ممکن است متوجه شویم که ستون Date هنوز بهصورت String ذخیره شده است.
بررسی اطلاعات کلی Dataset
df.info()
این دستور برای بررسی ساختار DataFrame بسیار مفید است.
بررسی Statistics اولیه
df.describe()
این دستور برای ستونهای عددی اطلاعاتی مانند:
- Count
- Mean
- Standard Deviation
- Minimum
- Quartiles
- Maximum
ارائه میکند.
مرحله 6: بررسی Missing Values
Missing Data یکی از مسائل رایج در Datasetهای واقعی است.
برای بررسی Missing Values:
df.isnull().sum()
مثلاً:
Age          12
Revenue       0
Category      5
یعنی در ستون Age دوازده مقدار و در Category پنج مقدار Missing وجود دارد.
آیا باید Missing Values را حذف کنیم؟
نه، همیشه.
روش برخورد با Missing Data به شرایط Dataset بستگی دارد.
روشهای احتمالی عبارتاند از:
حذف ردیفها
df.dropna()
جایگزینی با مقدار آماری
برای مثال:
df["Age"] = df["Age"].fillna(df["Age"].median())
استفاده از روشهای پیشرفتهتر
در پروژههای پیچیده ممکن است از روشهای آماری یا مدلمحور استفاده شود.
مهم این است که تصمیم درباره Missing Values باید بر اساس منطق داده و هدف تحلیل گرفته شود، نه صرفاً برای اینکه Dataset ظاهراً کامل شود.
مرحله 7: بررسی Duplicate Records
Duplicate Records میتوانند نتایج تحلیل را تغییر دهند.
برای بررسی:
df.duplicated().sum()
برای حذف Duplicateهای واقعی:
df = df.drop_duplicates()
اما قبل از حذف باید مشخص شود که رکورد تکراری واقعاً Duplicate است یا چند مشاهده معتبر از یک موجودیت.
مرحله 8: بررسی Data Types
نوع دادهها باید با معنای واقعی متغیر سازگار باشد.
مثلاً:
Age → Numeric
Revenue → Numeric
Category → Categorical
Date → Datetime
برای تبدیل Date:
df["Date"] = pd.to_datetime(df["Date"])
اکنون میتوانیم از ویژگیهای زمانی آن استفاده کنیم.
مثلاً:
df["Year"] = df["Date"].dt.year
df["Month"] = df["Date"].dt.month
مرحله 9: بررسی دادههای نامعتبر
همه مشکلات Dataset به Missing Values محدود نمیشوند.
ممکن است داده شامل مقادیر غیرمنطقی باشد.
مثلاً:
Age = -5
Quantity = -10
Price = -100
یا:
Gender = Male
Gender = male
Gender = M
در این شرایط باید Data Validation و Data Standardization انجام شود.
مرحله 10: Data Cleaning
اکنون میتوانیم فرآیند Data Cleaning را انجام دهیم.
این مرحله میتواند شامل:
- Missing Value Handling
- Duplicate Removal
- Type Conversion
- Invalid Value Detection
- Category Standardization
- Outlier Investigation
- Text Cleaning
باشد.
برای مثال:
df["Category"] = df["Category"].str.strip().str.lower()
این کد فاصلههای اضافی را حذف کرده و Categoryها را به حروف کوچک تبدیل میکند.
مرحله 11: Data Transformation
پس از Cleaning ممکن است داده نیاز به Transformation داشته باشد.
برای مثال:
df["Revenue"] = df["Price"] * df["Quantity"]
یا:
df["Profit"] = df["Revenue"] - df["Cost"]
همچنین میتوان:
- Columns ایجاد کرد.
- Variables را تبدیل کرد.
- Data را Group کرد.
- Tables را Merge کرد.
- Data را Reshape کرد.
مرحله 12: Filtering و Sorting
گاهی لازم است فقط بخشی از Dataset را بررسی کنیم.
مثلاً فروش بیشتر از 1000:
high_sales = df[df["Revenue"] > 1000]
یا مرتبسازی:
df.sort_values("Revenue", ascending=False)
مرحله 13: GroupBy و Aggregation
یکی از مهمترین عملیات در Data Analysis، Aggregation است.
برای مثال، مجموع فروش هر Category:
category_sales = (
    df.groupby("Category")["Revenue"]
      .sum()
)
یا میانگین فروش:
category_average = (
    df.groupby("Category")["Revenue"]
      .mean()
)
این نوع تحلیلها به ما اجازه میدهند Dataset بزرگ را به اطلاعات قابل تفسیر تبدیل کنیم.
مرحله 14: Exploratory Data Analysis — EDA
اکنون وارد یکی از مهمترین مراحل میشویم:
Exploratory Data Analysis
هدف EDA این است که ساختار Dataset، Distributionها، Relationshipها، Patternها و Anomalies را بهتر بشناسیم.
در EDA معمولاً بررسی میکنیم:
- Distribution
- Central Tendency
- Variability
- Correlation
- Outliers
- Trends
- Group Differences
- Relationships
Distribution Analysis
فرض کنید میخواهیم Distribution درآمد مشتریان را بررسی کنیم.
با Seaborn:
import seaborn as sns
import matplotlib.pyplot as plt

sns.histplot(data=df, x="Revenue")

plt.show()
این نمودار میتواند اطلاعاتی درباره شکل Distribution ارائه کند.
مرحله 15: بررسی Outliers
Outlier به مشاهدهای گفته میشود که نسبت به الگوی کلی داده فاصله غیرمعمولی دارد.
مثلاً:
10
12
11
13
12
500
عدد 500 ممکن است یک Outlier باشد.
اما نکته مهم:
هر Outlier الزاماً Error نیست.
ممکن است 500 واقعاً یک مقدار معتبر باشد.
بنابراین قبل از حذف Outlier باید علت آن بررسی شود.
مرحله 16: بررسی Relationships
یکی از اهداف EDA پیدا کردن Relationship میان Variables است.
مثلاً:
آیا Advertising Spend با Sales ارتباط دارد؟
میتوان Scatter Plot ایجاد کرد:
sns.scatterplot(
    data=df,
    x="Advertising",
    y="Sales"
)

plt.show()
اما مشاهده یک رابطه در نمودار به معنی اثبات Causation نیست.
Correlation Analysis
برای بررسی Correlation:
correlation = df.corr(numeric_only=True)

print(correlation)
یا Heatmap:
sns.heatmap(
    correlation,
    annot=True
)

plt.show()
Correlation میتواند نشان دهد دو متغیر تا چه اندازه با یکدیگر ارتباط خطی دارند.
اما:
Correlation does not imply causation.
وجود Correlation بهتنهایی ثابت نمیکند که یکی از متغیرها علت دیگری است.
مرحله 17: Statistical Analysis
پس از EDA، بسته به سؤال پژوهش یا Business Question ممکن است تحلیل آماری انجام شود.
مثلاً:
- Mean Comparison
- Confidence Intervals
- Hypothesis Testing
- Correlation Analysis
- Regression
- ANOVA
- Non-parametric Tests
انتخاب روش آماری باید بر اساس:
- Research Question
- Data Type
- Study Design
- Distribution
- Assumptions
- Sample Size
انجام شود.
Python ابزارهایی مانند SciPy و statsmodels را برای تحلیلهای آماری در اختیار کاربران قرار میدهد.
مرحله 18: Data Visualization
Visualization فقط برای زیباتر کردن گزارش نیست.
یک Visualization خوب باید به پاسخ دادن به یک سؤال کمک کند.
برای مثال:
Line Chart
برای Trendهای زمانی.
Bar Chart
برای مقایسه Categoryها.
Histogram
برای Distribution.
Scatter Plot
برای Relationship بین دو Variable.
Box Plot
برای Distribution و مقایسه گروهها.
انتخاب نمودار مناسب
| سؤال | Visualization مناسب |
|---|---|
| روند در طول زمان چیست؟ | Line Chart |
| کدام Category بیشتر است؟ | Bar Chart |
| Distribution چگونه است؟ | Histogram |
| رابطه دو Variable چیست؟ | Scatter Plot |
| تفاوت Distribution گروهها چیست؟ | Box Plot |
| ترکیب یک کل چگونه است؟ | Stacked / Part-to-Whole Charts |
انتخاب نمودار باید با هدف تحلیل هماهنگ باشد.
مرحله 19: استخراج Insights
اکنون مهمترین سؤال:
So what?
تحلیل داده زمانی ارزشمند میشود که بتواند از اعداد و نمودارها به یک Insight قابل تفسیر برسد.
فرض کنید نمودار نشان دهد:
January: 10,000
February: 11,000
March: 12,500
April: 8,000
یک Observation:
فروش در April کاهش یافته است.
اما Insight میتواند دقیقتر باشد:
فروش در April نسبت به March کاهش قابل توجهی داشته و این کاهش عمدتاً در Category X مشاهده شده است.
در مرحله بعد باید بررسی شود که علت احتمالی چیست و آیا داده کافی برای چنین استنباطی وجود دارد یا خیر.
Observation vs Insight
این تفاوت بسیار مهم است.
Observation
Sales decreased in April.
Insight
Sales decreased in April, with the largest decline occurring in Category X and Channel Y.
Actionable Insight
The April decline is concentrated in Category X and Channel Y; further investigation of campaign activity, pricing, and inventory is warranted.
یک تحلیل حرفهای باید تا حد امکان از Description به سمت Interpretation و در صورت امکان Actionable Insight حرکت کند، بدون اینکه فراتر از شواهد موجود ادعا کند.
مرحله 20: Communication of Results
تحلیل خوب اگر بهدرستی منتقل نشود، ممکن است ارزش عملی محدودی داشته باشد.
نتایج میتوانند در قالب:
- Report
- Dashboard
- Presentation
- Notebook
- Visualization
- Executive Summary
ارائه شوند.
یک گزارش خوب باید مشخص کند:
- سؤال چه بود؟
- چه دادهای استفاده شد؟
- چه روش تحلیلی به کار رفت؟
- مهمترین یافتهها چه بودند؟
- محدودیتها چیست؟
- چه اقدام یا بررسی بعدی پیشنهاد میشود؟
مرحله 21: Reproducibility
یکی از مزایای Python این است که میتوان Workflow را به شکل Code ذخیره کرد.
مثلاً:
01_load_data.py
02_clean_data.py
03_eda.py
04_analysis.py
05_visualization.py
یا همه مراحل را در یک Jupyter Notebook مستند کرد.
یک ساختار پروژه میتواند چنین باشد:
data-analysis-project/
│
├── data/
│   ├── raw/
│   └── processed/
│
├── notebooks/
│   └── analysis.ipynb
│
├── src/
│   ├── cleaning.py
│   ├── analysis.py
│   └── visualization.py
│
├── outputs/
│   ├── figures/
│   └── reports/
│
└── README.md
این ساختار به سازماندهی و Reproducibility پروژه کمک میکند.
مرحله 22: Validation و Quality Check
قبل از انتشار نتایج، باید بررسی کنیم که تحلیل درست انجام شده است.
سؤالات مهم:
- آیا Dataset صحیح استفاده شده است؟
- آیا Duplicateها مدیریت شدهاند؟
- آیا Missing Values بررسی شدهاند؟
- آیا Units درست هستند؟
- آیا Filter اشتباهی اعمال نشده است؟
- آیا Calculationها صحیح هستند؟
- آیا نمودارها با داده مطابقت دارند؟
- آیا Statistical Assumptions بررسی شدهاند؟
- آیا نتیجهگیری از داده فراتر رفته است؟
این مرحله برای جلوگیری از Analytical Errors بسیار مهم است.
یک پروژه کامل Python Data Analysis
فرض کنید یک Dataset مربوط به فروش داریم:
sales.csv
Workflow کامل:
Business Question
       ↓
Load CSV
       ↓
Inspect Dataset
       ↓
Clean Data
       ↓
Transform Variables
       ↓
EDA
       ↓
Statistical Analysis
       ↓
Visualization
       ↓
Insights
       ↓
Report
مثال عملی با Python
ابتدا کتابخانهها را Import میکنیم:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
داده را Load میکنیم:
df = pd.read_csv("sales.csv")
ساختار را بررسی میکنیم:
print(df.shape)
print(df.info())
Missing Values:
print(df.isnull().sum())
Duplicateها:
print(df.duplicated().sum())
آمار توصیفی:
print(df.describe())
Date را تبدیل میکنیم:
df["Date"] = pd.to_datetime(df["Date"])
Revenue را محاسبه میکنیم:
df["Revenue"] = df["Price"] * df["Quantity"]
فروش بر اساس Category:
category_sales = (
    df.groupby("Category")["Revenue"]
      .sum()
      .sort_values(ascending=False)
)

print(category_sales)
Visualization:
category_sales.plot(kind="bar")

plt.title("Revenue by Category")
plt.xlabel("Category")
plt.ylabel("Revenue")

plt.show()
اکنون میتوانیم از داده یک سؤال مشخص را پاسخ دهیم.
یک Workflow حرفهایتر
در پروژههای واقعی، Workflow میتواند کمی پیچیدهتر باشد:
                 Business Question
                         ↓
                  Data Requirements
                         ↓
                    Data Sources
                         ↓
                 Data Acquisition
                         ↓
                  Data Validation
                         ↓
                   Data Cleaning
                         ↓
                 Data Transformation
                         ↓
                        EDA
                         ↓
               Statistical Analysis
                         ↓
                  Visualization
                         ↓
                   Interpretation
                         ↓
                  Insight Validation
                         ↓
                   Communication
                         ↓
                Decision / Action
نکته مهم این است که Workflow همیشه کاملاً Linear نیست.
ممکن است در EDA متوجه یک مشکل در داده شوید و دوباره به Data Cleaning برگردید.
یا هنگام تحلیل متوجه شوید که به Variable دیگری نیاز دارید و دوباره به Data Collection مراجعه کنید.
بنابراین Data Analysis بیشتر شبیه یک Iterative Process است تا یک خط مستقیم.
آیا هر پروژه Data Analysis باید Machine Learning داشته باشد؟
خیر.
این یکی از اشتباهات رایج مبتدیان است.
اگر سؤال شما این باشد:
«کدام محصول بیشترین فروش را دارد؟»
احتمالاً نیازی به Machine Learning ندارید.
اگر سؤال این باشد:
«آیا میتوان فروش آینده را پیشبینی کرد؟»
ممکن است Predictive Modeling مناسب باشد.
بنابراین:
Machine Learning یک ابزار برای برخی مسائل است، نه مرحله اجباری هر پروژه Data Analysis.
آیا هر پروژه Data Analysis به Statistics پیشرفته نیاز دارد؟
خیر.
سطح Statistics باید با سؤال و طراحی مطالعه متناسب باشد.
برای برخی پروژهها:
- Descriptive Statistics
کافی است.
برای پروژههای دیگر ممکن است نیاز به:
- Hypothesis Testing
- Regression
- ANOVA
- Time-Series Analysis
باشد.
نقش Python Libraries در Workflow
| مرحله | ابزارهای رایج |
|---|---|
| Data Loading | Pandas |
| Numerical Computing | NumPy |
| Data Cleaning | Pandas |
| Transformation | Pandas / NumPy |
| EDA | Pandas / NumPy |
| Statistics | SciPy / statsmodels |
| Visualization | Matplotlib / Seaborn |
| Machine Learning | scikit-learn |
| Notebook | Jupyter |
این جدول یک راهنمای عمومی است و انتخاب Library باید بر اساس پروژه انجام شود.
اشتباهات رایج در Python Data Analysis
اشتباه 1: شروع با Visualization
برخی افراد بلافاصله نمودار ایجاد میکنند.
در حالی که ابتدا باید بدانند:
چه سؤالی را میخواهند پاسخ دهند؟
اشتباه 2: حذف تمام Missing Values
این کار ممکن است اطلاعات ارزشمند را از Dataset حذف کند.
اشتباه 3: حذف تمام Outliers
Outlier ممکن است Error یا Observation واقعی باشد.
اشتباه 4: تفسیر Correlation بهعنوان Causation
Correlation بهتنهایی رابطه علت و معلولی را ثابت نمیکند.
اشتباه 5: استفاده از Machine Learning بدون نیاز
همه مسائل Data Analysis نیازمند Machine Learning نیستند.
اشتباه 6: تمرکز بیش از حد روی Code
Data Analysis فقط Programming نیست.
Business Understanding، Statistics و Domain Knowledge نیز اهمیت دارند.
اشتباه 7: نتیجهگیری بیش از حد
نتیجه باید متناسب با شواهد باشد.
اگر Dataset فقط نشاندهنده Correlation است، نباید بدون طراحی مناسب مطالعه ادعای Causal Effect کرد.
Python Data Analysis Workflow برای مبتدیان
اگر تازه شروع کردهاید، لازم نیست تمام Workflowهای پیچیده را یاد بگیرید.
با این مسیر شروع کنید:
1. Define the Question
        ↓
2. Load the Data
        ↓
3. Inspect the Data
        ↓
4. Clean the Data
        ↓
5. Explore the Data
        ↓
6. Visualize the Data
        ↓
7. Interpret the Results
        ↓
8. Communicate the Findings
پس از کسب تجربه میتوانید موارد زیر را اضافه کنید:
- Statistical Testing
- Automation
- SQL
- APIs
- Machine Learning
- Advanced Visualization
- Reproducible Pipelines
پروژه پیشنهادی برای یادگیری
برای تمرین Workflow میتوانید یک Dataset فروش انتخاب کنید و این سؤال را بررسی کنید:
Which product categories generate the highest revenue?
سپس:
Step 1
Dataset را Load کنید.
Step 2
Structure را بررسی کنید.
Step 3
Missing Values را بررسی کنید.
Step 4
Duplicate Records را بررسی کنید.
Step 5
Data Types را اصلاح کنید.
Step 6
Revenue را محاسبه کنید.
Step 7
داده را بر اساس Category Group کنید.
Step 8
Bar Chart ایجاد کنید.
Step 9
نتایج را تفسیر کنید.
Step 10
یک گزارش کوتاه بنویسید.
این پروژه ساده، تقریباً تمام اجزای اصلی یک Workflow ابتدایی Data Analysis را تمرین میکند.
Python Data Analysis Workflow در یک جمله
اگر بخواهیم کل فرآیند را در یک جمله خلاصه کنیم:
Python Data Analysis Workflow فرآیندی است برای تبدیل یک سؤال مشخص و Raw Data به تحلیل معتبر، Visualization قابل فهم و Insight قابل استفاده.
یا:
Question
   ↓
Data
   ↓
Clean
   ↓
Transform
   ↓
Explore
   ↓
Analyze
   ↓
Visualize
   ↓
Interpret
   ↓
Communicate
   ↓
Insight
جمعبندی
یک Data Analysis حرفهای از Python شروع نمیشود؛ از Question شروع میشود.
Python در ادامه به ما کمک میکند تا داده را:
Load → Clean → Transform → Explore → Analyze → Visualize
کنیم.
اما مرحله نهایی، تبدیل خروجی محاسبات به Insight است.
یک Workflow مناسب باید:
- هدف مشخص داشته باشد.
- Data Requirements را تعیین کند.
- کیفیت داده را بررسی کند.
- Missing Values را مدیریت کند.
- Duplicateها را بررسی کند.
- Data Types را اصلاح کند.
- Data Cleaning انجام دهد.
- EDA انجام دهد.
- روش آماری مناسب انتخاب کند.
- Visualization مناسب ایجاد کند.
- نتایج را اعتبارسنجی کند.
- محدودیتها را مشخص کند.
- یافتهها را به زبان قابل فهم منتقل کند.
بنابراین هدف اصلی یادگیری Python for Data Analysis این نیست که تعداد زیادی دستور Python را حفظ کنیم.
هدف این است که بتوانیم:
از داده خام، شواهد معتبر و قابل تفسیر استخراج کنیم.
Frequently Asked Questions — FAQ
Python Data Analysis Workflow چیست؟
Python Data Analysis Workflow مجموعهای از مراحل برای تبدیل Raw Data به Meaningful Insights است. این فرآیند معمولاً شامل Problem Definition، Data Collection، Data Cleaning، EDA، Statistical Analysis، Visualization و Communication است.
اولین مرحله Data Analysis چیست؟
اولین مرحله معمولاً تعریف دقیق سؤال یا مسئله تحلیلی است. قبل از تحلیل باید مشخص شود که چه چیزی قرار است از داده یاد گرفته شود.
آیا Python برای تمام مراحل Data Analysis استفاده میشود؟
Python میتواند در بسیاری از مراحل استفاده شود، اما لزوماً تنها ابزار پروژه نیست. SQL، Excel، Databases و ابزارهای BI نیز میتوانند بخشی از Workflow باشند.
مهمترین کتابخانه Python برای Data Analysis چیست؟
Pandas یکی از مهمترین کتابخانهها برای کار با دادههای جدولی است. NumPy برای Numerical Computing و Matplotlib و Seaborn برای Visualization نیز بسیار رایج هستند.
Data Cleaning چیست؟
Data Cleaning فرآیندی برای شناسایی و مدیریت مشکلات داده مانند Missing Values، Duplicate Records، Invalid Values، Inconsistent Categories و Data Typeهای نامناسب است.
EDA چیست؟
Exploratory Data Analysis (EDA) فرآیندی برای شناخت ساختار، Distribution، Relationship، Pattern و Anomalyهای موجود در Dataset است.
آیا Correlation به معنی Causation است؟
خیر. Correlation نشاندهنده وجود یک رابطه آماری است و بهتنهایی رابطه علت و معلولی را ثابت نمیکند.
آیا همه پروژههای Data Analysis به Machine Learning نیاز دارند؟
خیر. بسیاری از مسائل Data Analysis با Descriptive Statistics، Aggregation، Visualization و Statistical Analysis قابل بررسی هستند.
آیا Data Analysis فقط با Python انجام میشود؟
خیر. Python یکی از ابزارهای مهم Data Analysis است، اما SQL، R، Excel، MATLAB و ابزارهای Business Intelligence نیز در حوزههای مختلف استفاده میشوند.
آیا Python برای مبتدیان مناسب است؟
Python به دلیل Syntax نسبتاً خوانا و اکوسیستم گسترده، نقطه شروع مناسبی برای بسیاری از افرادی است که قصد ورود به Programming و Data Analysis را دارند؛ اما یادگیری واقعی Data Analysis علاوه بر Python به Statistics، Data Literacy و Problem Solving نیز نیاز دارد.
مسیر مرتبط در Academy-Tech
این مقاله میتواند در Python Data Analysis Topic Cluster سایت Academy-Tech بهعنوان مقالهای درباره فرآیند کامل تحلیل داده قرار گیرد.
ساختار پیشنهادی این Cluster:
Python for Data Analysis
        │
        ├── What Is Data Analysis and Why Use Python?
        │
        ├── Python for Data Analysis:
        │   Complete Beginner's Guide
        │
        ├── Why Python Is Widely Used
        │   for Data Analysis
        │
        ├── Python Data Analysis Workflow
        │   From Raw Data to Insights
        │
        ├── NumPy for Data Analysis
        │
        ├── Pandas for Data Analysis
        │
        ├── Data Cleaning with Python
        │
        ├── Exploratory Data Analysis with Python
        │
        ├── Data Visualization with Python
        │
        ├── Statistics with Python
        │
        ├── SQL for Data Analysis
        │
        └── Python Data Analysis Projects
در این ساختار، مقاله حاضر یک Workflow / Process Guide است؛ بنابراین بهتر است از آن به مقالات Pandas، Data Cleaning، EDA، Visualization و Statistics لینک داخلی داده شود و بالعکس.